图1 新一代人工智能国家科技重大专项2026年度立项项目启动会
2026年10月23日,新一代人工智能国家科技重大专项2026年度立项项目启动会举行。北京大学深圳研究生院科学智能学院助理教授袁粒牵头申报承担的“AI驱动多肽候选药物发现的干湿闭环数据生产线”项目正式启动。项目面向人工智能驱动的生命科学研究与多肽候选药物发现需求,致力于推动计算预测、自动化实验与科学数据生产深度融合,探索智能化药物研发的新模式。
该项目由北京大学深圳研究生院牵头,联合深圳湾实验室、哈尔滨工业大学(深圳)、汇像智能科技(上海)有限公司、上海交通大学等单位协同开展,发挥人工智能、生命科学、自动化实验及数据工程等领域的交叉优势,围绕关键技术研发、系统集成与应用验证开展联合攻关。
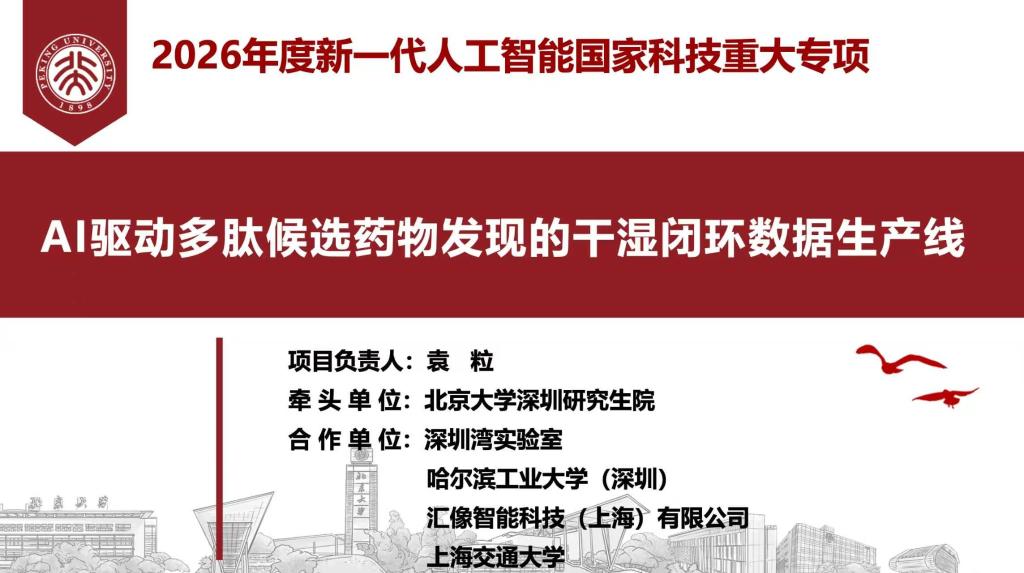
图2 项目名称、负责人、牵头单位及合作单位
聚焦现实挑战,破解生命科学数据生产瓶颈
当前,生命科学研究正加速迈向人工智能驱动的新阶段,高质量科学数据已成为支撑模型训练、科学发现和科研范式变革的战略性基础资源。然而,面向AI for Science的数据生产仍面临结构性瓶颈:但支撑模型训练与科学发现的高质量数据仍面临生产成本高、获取效率低等问题。一方面,结构预测、分子生成与性质预测、候选分子性能预测等计算环节尚缺乏连贯衔接;另一方面,传统实验存在周期较长、通量有限、结果复现难和成本较高等制约。同时,跨地区、跨机构的数据分散于不同系统,数据格式与标准差异明显,增加了共享、整合与复用的难度。数据供给能力不足,正成为制约人工智能深度赋能生命科学的关键变量。
针对“有算力缺数据、有静态缺迭代、有孤岛缺汇聚”等共性难题,项目将人工智能算法、自动化实验技术与数据标准化体系相结合,以数据生产流程的系统性重构为切入点,探索形成计算、实验和数据持续相互反馈的科研闭环。
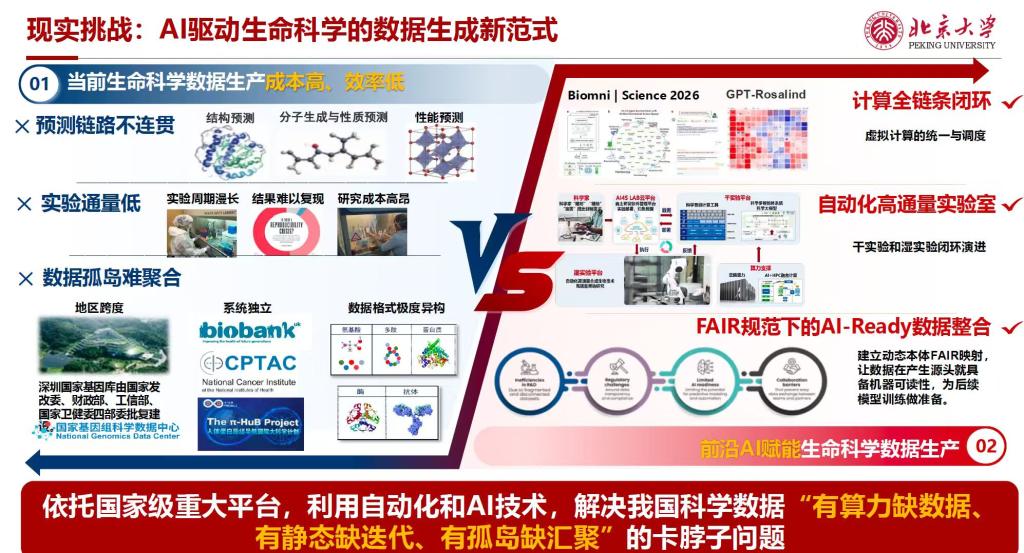
图3 项目拟解决的现实挑战与AI驱动的干湿闭环数据生产技术方向
贯通计算与实验,构建AI驱动的干湿闭环体系
围绕多肽候选药物发现,项目拟重点推进三个相互衔接的研究方向:一是计算全链条闭环,衔接结构预测、分子生成、性质及性能预测等环节,探索计算任务的统一组织与调度;二是自动化高通量实验,推动计算端的候选方案与真实实验验证高效协同,通过实验数据回流促进模型与研究策略迭代;三是FAIR规范下的AI-Ready数据整合,探索动态本体映射和规范化数据组织,使科学数据在生产源头具备更好的机器可读性、互操作性与可复用性,为后续模型训练和智能分析奠定基础。
通过“AI设计与预测—自动化实验验证—数据规范化汇聚—模型反馈优化”的连续流程,项目力求缩短候选多肽从计算筛选到实验验证的迭代路径,推动数据由分散、静态的研究记录转变为可持续积累、可计算利用的科研资源,为多肽候选药物发现提供高质量数据与智能化技术支撑。
发挥多方协同优势,推进人工智能与生物医药深度融合
组织保障上,项目按照重大专项要求实行牵头单位负总责、关键节点考核和动态调整机制。我院作为牵头单位,将与合作单位在算法研究、生命科学、自动化及数据平台方面的研究基础,建立跨学科、跨机构的协同研究机制,扎实推进关键技术攻关、数据生产流程优化及系统集成验证。
据悉,新一代人工智能国家科技重大专项,是我国中央财政科技计划(专项、基金等)五类计划之一。根据国发〔2014〕64号文件,五类计划分别为国家自然科学基金、国家科技重大专项、国家重点研发计划、技术创新引导专项(基金)、基地和人才专项。
国家科技重大专项定位于聚焦国家重大战略产品和产业化目标,发挥举国体制优势,在设定时限内进行集成式协同攻关。新一代人工智能国家科技重大专项由2017年国务院《新一代人工智能发展规划》部署设立,在“1+N”人工智能项目群中居于核心地位,聚焦人工智能关键理论、基础能力与复杂系统应用的整体攻关,当前重点布局跨学科科学发现系统、AI-Ready科学数据服务平台等基础性任务。
本项目为我院首个牵头获批的国家科技重大专项。此次项目启动,是北京大学深圳研究生院推进人工智能与生命科学交叉研究的重要实践。未来,袁粒团队将联合各合作单位,围绕关键任务开展协同攻关,为AI赋能科学数据生产、药物发现和生命科学研究范式创新提供支撑。